Машинное обучение с нуля: roadmap от NumPy и pandas до PyTorch
Машинное обучение (machine learning, ML) — это способ создавать программы, которые находят правила сами, из примеров, вместо того чтобы программист прописывал эти правила вручную. Вы даёте алгоритму данные с известными ответами, он подбирает закономерность — и затем применяет её к новым данным, которых ещё не видел.
Изучить машинное обучение с нуля реально, но большинство новичков спотыкается не о сложность, а о порядок: открывают курс о нейронных сетях, не понимают, что такое «форма тензора», и бросают. Эта статья — roadmap из пяти этапов: что учить, в какой последовательности, сколько это занимает и чем должен закончиться каждый шаг.
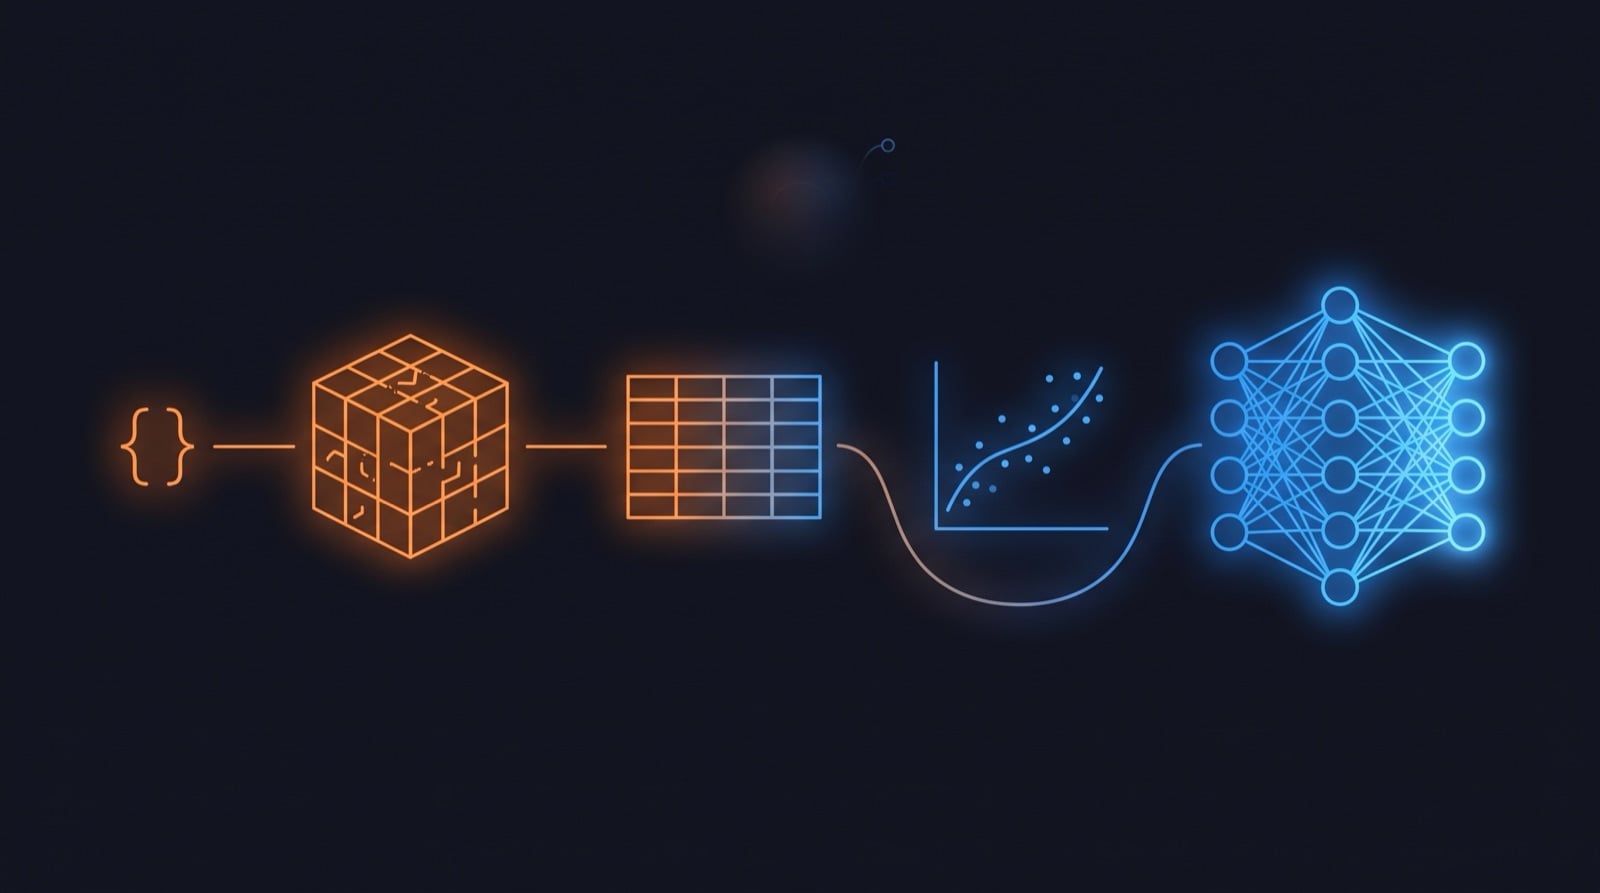
Коротко. Маршрут в машинное обучение: Python → NumPy → pandas → scikit-learn → PyTorch. NumPy даёт язык массивов, на котором «разговаривают» все модели; pandas превращает грязные таблицы в данные для модели; scikit-learn учит классическим алгоритмам и честной оценке качества; PyTorch — нейронным сетям вплоть до трансформера. При 8–10 часах в неделю весь путь занимает 8–12 месяцев. Математика нужна, но школьной достаточно для старта — остальное добирают по дороге.
Roadmap одним взглядом: 5 этапов
| Этап | Что учите | Зачем | Ориентировочное время* | Результат этапа |
|---|---|---|---|---|
| 1. Python | Переменные, циклы, функции, списки, словари | Язык, на котором написана вся ML-экосистема | 4–6 недель | Пишете небольшие программы без подсказок |
| 2. NumPy | Массивы, форма, срезы, векторизация, broadcasting | Формат данных, который принимает любая модель | 3–4 недели | Линейная регрессия, написанная вручную на NumPy |
| 3. pandas | DataFrame, пропуски, типы, даты, объединения, кодирование признаков | Реальные данные грязные — их нужно готовить | 5–7 недель | Грязный файл превращён в таблицу для модели |
| 4. Классическое ML (scikit-learn) | Регрессия, классификация, метрики, переобучение, кластеризация | Основа мышления: как модель учится и как её честно оценить | 6–8 недель | Полный ML-проект от данных до оценённой модели |
| 5. Глубокое обучение (PyTorch) | Тензоры, autograd, цикл обучения, CNN, RNN, внимание, трансформер | Изображения, текст, языковые модели | 8–12 недель | Собственная маленькая языковая модель |
* При 8–10 часах занятий в неделю. Это ориентиры для планирования, а не норматив: с опытом программирования первые этапы проходят вдвое быстрее.
Именно в такой последовательности построен учебный путь «Data Science и машинное обучение на Python» в курсах по подписке Prog Academy: бесплатный курс Python, затем NumPy, pandas, основы машинного обучения и PyTorch. Ниже — каждый этап подробно.
Почему порядок важнее скорости
Каждый слой ML-стека стоит на предыдущем — буквально, на уровне кода:
- pandas построен поверх NumPy. Столбец DataFrame — это массив с подписями.
- scikit-learn принимает массивы. Метод
fit(X, y)ожидает матрицу признаков определённой формы — если вы не понимаете, что такое(n_samples, n_features), первая же ошибка поставит в тупик. - Тензор PyTorch — это массив NumPy с двумя дополнениями: он умеет считать градиенты и работать на GPU. Индексация, срезы, broadcasting — те же.
Поэтому «перескочить» к нейронным сетям не получается: пробел с нижнего уровня возвращается в виде непонятных ошибок на верхнем. И наоборот — кто хорошо усвоил NumPy, тот читает код PyTorch почти без перевода.
Этап 1. Python: ровно столько, сколько нужно
Для машинного обучения не нужен «весь Python». Нужен уверенный базовый уровень:
- переменные, типы, условия и циклы;
- функции и их аргументы;
- списки, словари, кортежи, срезы;
- чтение файлов и работа с модулями (
import); - основы классов — чтобы понимать запись вроде
class Net(nn.Module)в PyTorch.
Декораторы, метаклассы, асинхронность на этом этапе можно смело пропустить. Критерий готовности простой: вы можете без подсказок написать функцию, которая читает файл, считает по нему статистику и возвращает результат.
Где учить: бесплатный курс Python — первый шаг учебного пути, с практикой в браузере. Если вам ближе аналитика, чем модели, посмотрите также гид «Python для анализа данных».
Этап 2. NumPy: язык, на котором разговаривают модели
NumPy — это библиотека Python для быстрых вычислений над массивами чисел. Любая модель машинного обучения — от линейной регрессии до нейронной сети — получает на вход массивы чисел и возвращает массивы чисел. Изображение — это массив пикселей, текст — массив номеров токенов, таблица клиентов — матрица «строки × признаки».
Что обязательно понять:
- Форма массива (shape) и оси. Большинство ошибок новичков в ML — это ошибки формы: модель ждёт
(100, 3), а получает(100,). - Индексация, срезы и булевы маски — как достать нужные строки и столбцы.
- Векторизация. Одна операция над всем массивом вместо цикла — в десятки раз быстрее и короче.
- Агрегации по осям: среднее по столбцам против среднего по строкам.
- Broadcasting — правила, по которым NumPy сочетает массивы разной формы.
- Основы линейной алгебры: скалярное произведение и умножение матриц.
Вот как выглядит векторизация — стандартизация признаков без единого цикла:
import numpy as np

X = np.array([[170, 65], [182, 80], [158, 52]])  # рост, вес

# среднее и стандартное отклонение по каждому столбцу (ось 0)
X_scaled = (X - X.mean(axis=0)) / X.std(axis=0)
print(X_scaled.shape)  # (3, 2)
Здесь в одной строке работают сразу три идеи: агрегация по оси, broadcasting и векторизованная арифметика. Именно так написана предварительная обработка данных в реальных ML-проектах.
Чем должен закончиться этап: вы реализуете линейную регрессию вручную — только на NumPy, без готовых библиотек. После этого «обучение модели» перестаёт быть чёрным ящиком.
Где учить: курс «Числовые основы: NumPy для машинного обучения» — 9 разделов от массивов и срезов до broadcasting, а итоговый проект — та самая линейная регрессия на NumPy.
Этап 3. pandas: от грязного файла к данным для модели
pandas — это библиотека для работы с таблицами (DataFrame): загрузка, очистка, преобразование и объединение данных. В учебных датасетах данные чистые. В реальных — лишние пробелы в названиях, цены вроде "$1,299.00", даты в трёх форматах, дубликаты клиентов и пропуски в половине столбцов.
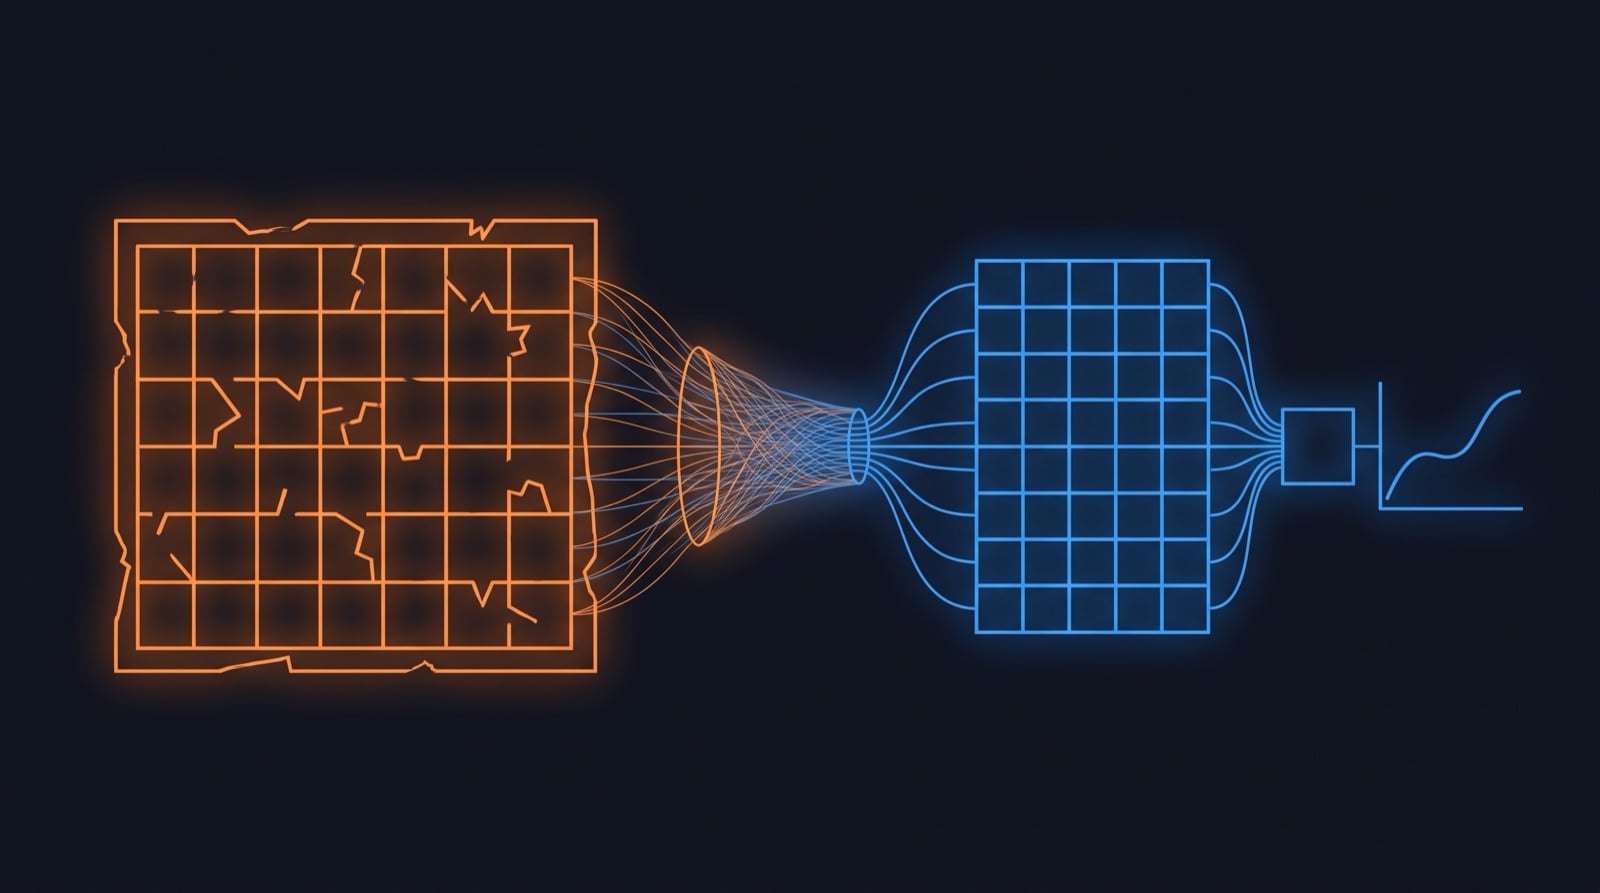
Качество модели почти всегда ограничено качеством данных, а не выбором алгоритма. Поэтому подготовка данных — не «скучная часть перед настоящим ML», а большая половина работы.
Что нужно уметь:
- загружать CSV и Excel, быстро осматривать набор данных (
info,describe); - фильтровать строки и выбирать столбцы;
- работать с пропущенными значениями: находить, удалять, заполнять;
- исправлять типы, чистить текст, убирать дубликаты;
- разбирать даты и время;
- группировать и агрегировать (
groupby), объединять таблицы (merge); - кодировать категориальные признаки и масштабировать числовые;
- создавать новые признаки (feature engineering) и находить выбросы.
import pandas as pd

df = pd.read_csv("orders.csv")

df["price"] = df["price"].str.replace("[$,]", "", regex=True).astype(float)
df["city"] = df["city"].str.strip().str.title()
df = df.drop_duplicates(subset="order_id")
df["price"] = df["price"].fillna(df["price"].median())
Четыре строки — и цена стала числом, города записаны одинаково, дубликаты убраны, пропуски заполнены. Такие правила пишутся один раз и применяются к каждой новой выгрузке.
Чем должен закончиться этап: вы берёте действительно грязный файл и проходите весь путь до таблицы, на которой можно обучать модель.
Где учить: курс «Подготовка данных с pandas» — 13 разделов, включая кодирование, масштабирование, инженерию признаков и итоговый проект. Если данные у вас лежат в базе, понадобится ещё и SQL — см. «SQL для начинающих».
Этап 4. Классическое машинное обучение на scikit-learn
Это сердце всего маршрута. scikit-learn — стандартная библиотека Python для классического машинного обучения: в ней все основные алгоритмы имеют одинаковый интерфейс fit / predict. Но главное на этом этапе — не алгоритмы, а способ мышления.
Три типа задач, которые нужно различать
| Тип задачи | Что предсказываем | Пример | Типичные метрики |
|---|---|---|---|
| Регрессия | Число | Цена квартиры, спрос на следующую неделю | MAE, RMSE, R² |
| Классификация | Категорию | Спам или не спам, уйдёт ли клиент | Accuracy, precision, recall, F1 |
| Кластеризация (без учителя) | Группы, которые заранее никто не разметил | Сегменты клиентов | Silhouette, визуальная проверка |
Идеи, без которых дальше нельзя
- Признаки и метки. Что модель видит на входе и что она должна предсказать.
- Честное разделение на обучающую и тестовую выборки. Модель оценивают только на данных, которых она не видела.
- Переобучение (overfitting) и недообучение. Модель, зазубрившая обучающие примеры, показывает отличную метрику на них и проваливается на новых.
- Кросс-валидация — более надёжная оценка, чем одно разделение.
- Утечка данных (data leakage). Если информация из тестовой выборки попала в обучение, метрика врёт.
- Выбор метрики под задачу. Accuracy 99% ничего не значит, если 99% примеров относятся к одному классу.
Минимальный полный цикл в scikit-learn выглядит так:
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import f1_score

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

model = make_pipeline(StandardScaler(), LogisticRegression())
model.fit(X_train, y_train)

print(f1_score(y_test, model.predict(X_test)))
Обратите внимание на make_pipeline: масштабирование обучается только на обучающей выборке — это и есть защита от утечки данных. Такие детали отличают модель, которая работает в ноутбуке, от модели, которая работает на реальных данных.
Чем должен закончиться этап: самостоятельный проект на табличных данных — от постановки задачи до вывода «модель даёт такое-то качество, и вот почему ей можно (или нельзя) доверять».
Где учить: курс «Основы машинного обучения: от первой модели до готового ML-проекта» — 10 разделов: данные и честное разделение, регрессия, классификация и метрики, подготовка признаков в scikit-learn, переобучение, кластеризация и итоговый проект.
Этап 5. Глубокое обучение на PyTorch
Глубокое обучение (deep learning) — это часть машинного обучения, где модель состоит из многих слоёв нейронной сети и сама учится выделять признаки из сырых данных: пикселей, звука, текста. PyTorch — фреймворк для построения и обучения таких сетей; на нём публикуется большинство современных открытых моделей.
Последовательность тем внутри этапа тоже имеет значение:
- Тензоры — те же массивы NumPy, только с поддержкой GPU.
- Autograd — автоматическое вычисление градиентов, двигатель обучения любой сети.
- Модель как
nn.Module— слои, параметры, прямой проход. - Цикл обучения: функция потерь, оптимизатор, эпохи.
- Данные:
DatasetиDataLoader, батчи. - Свёрточные сети (CNN) — для изображений.
- Рекуррентные сети (RNN, LSTM, GRU) — для последовательностей.
- Регуляризация и работа с реальными данными.
- Механизм внимания (attention).
- Трансформер — архитектура, на которой построены GPT, Claude и другие большие языковые модели.
Цикл обучения — пять строк, которые стоит знать наизусть, потому что они одинаковы и для сети из двух слоёв, и для языковой модели:
for X_batch, y_batch in loader:
    optimizer.zero_grad()            # сбрасываем старые градиенты
    loss = loss_fn(model(X_batch), y_batch)  # прямой проход и потери
    loss.backward()                  # градиенты через autograd
    optimizer.step()                 # обновляем веса
Чем должен закончиться этап: вы собираете трансформер и обучаете собственную маленькую языковую модель. Она не заменит ChatGPT, но после этого вы понимаете, как устроены большие модели — на уровне кода, а не метафор.
Где учить: курс «PyTorch и глубокое обучение: от тензоров до трансформера» — продвинутый курс из 10 разделов для тех, кто уже уверенно пишет на Python: от тензоров и autograd до внимания, трансформера и собственной языковой модели.
Какая математика нужна для машинного обучения
Самый распространённый миф — «сначала нужно полгода учить высшую математику». На самом деле для старта хватает школьной, а остальное удобнее добирать вместе с кодом, когда видно, зачем она.
| Тема | Что именно нужно | Где появляется в маршруте |
|---|---|---|
| Линейная алгебра | Векторы, матрицы, скалярное произведение, умножение матриц | NumPy (этап 2), слои нейронной сети (этап 5) |
| Статистика | Среднее, медиана, дисперсия, распределение, корреляция | pandas (этап 3), оценка моделей (этап 4) |
| Анализ | Производная как «наклон», градиент, идея градиентного спуска | Линейная регрессия на NumPy (этап 2), autograd (этап 5) |
| Вероятность | Базовые понятия: вероятность события, условная вероятность | Классификация и метрики (этап 4) |
Доказывать теоремы не нужно. Нужно понимать, что делает операция с данными — и уметь проверить это кодом на маленьком примере.
Сколько времени занимает весь путь
Если сложить этапы, получается 26–37 недель чистого обучения, то есть 6–9 месяцев при 8–10 часах в неделю. Добавьте время на собственные проекты и повторение — и реалистичная оценка составляет 8–12 месяцев до уровня, на котором вы самостоятельно ведёте ML-проект от сырых данных до оценённой модели.
- Через 2–3 месяца (Python + NumPy) вы свободно работаете с массивами и понимаете, как устроено обучение простейшей модели.
- Через 4–5 месяцев (+ pandas) вы готовите реальные данные — этого уже достаточно для задач аналитики.
- Через 6–7 месяцев (+ классическое ML) у вас есть первый полный ML-проект для портфолио.
- Через 9–12 месяцев (+ PyTorch) вы строите и отлаживаете нейронные сети.
Маршрут не обязательно проходить до конца. Для аналитика данных естественная точка остановки — после этапа 4.
Проекты для портфолио на каждом этапе
| Этап | Проект | Что он доказывает |
|---|---|---|
| NumPy | Линейная регрессия с градиентным спуском без библиотек ML | Вы понимаете, что происходит внутри fit |
| pandas | Очистка и исследование открытого «грязного» датасета | Вы умеете работать с реальными данными |
| scikit-learn | Предсказание оттока клиентов или цены со сравнением нескольких моделей | Вы умеете честно оценивать качество и объяснять выбор метрики |
| PyTorch | Классификатор изображений на CNN или маленькая языковая модель | Вы умеете строить и отлаживать нейронные сети |
Один доведённый до конца проект с описанием в README ценнее десяти незаконченных ноутбуков. Выкладывайте код на GitHub — если ещё не работали с ним, начните с гида «Git для начинающих».
7 ошибок, из-за которых новички бросают машинное обучение
- Начать с нейронных сетей. Без NumPy и классического ML это заучивание чужого кода.
- Полгода учить математику «про запас». Мотивация заканчивается раньше, чем появляется первая модель.
- Смотреть видео вместо того, чтобы писать код. Понимание появляется, только когда вы сами исправляете ошибку формы массива.
- Работать только с чистыми учебными датасетами. Первый реальный файл становится шоком.
- Оценивать модель на данных, на которых она училась. Метрика получается отличной и ничего не значит.
- Просить AI написать всё за вас. Ассистент полезен как преподаватель — «объясни эту строку», — но не как замена пониманию.
- Не доводить проекты до конца. Именно последние 20% — оценка, выводы, оформление — и показывают уровень.
Машинное обучение в эпоху ChatGPT и Claude: есть ли смысл учить
Большие языковые модели изменили то, как пишут код, но не отменили необходимость понимать модели. Наоборот:
- AI пишет код обучения за секунды — и так же уверенно ошибается. Утечка данных, неправильная метрика, переобучение не видны в коде, который «просто работает». Их видит только тот, кто понимает процесс.
- Большинство бизнес-задач — табличные. Прогноз спроса, скоринг, отток клиентов решают классическим ML, а не языковыми моделями: это дешевле, быстрее и проще объяснить.
- LLM — это тоже нейронные сети. Понимание трансформера помогает трезво оценивать, что модель может, а чего нет, — и строить на ней продукты. Практическая сторона этого описана в статье «Как создать AI-агента на Python».
Спрос это подтверждает: Бюро статистики труда США прогнозирует рост занятости data scientists на 34% в 2024–2034 годах — значительно быстрее среднего темпа по рынку.
Как пройти этот roadmap в Prog Academy
Все пять этапов собраны в учебный путь «Data Science и машинное обучение на Python». Опыт программирования не нужен — первый курс начинается с нуля; понадобится школьная математика.
| Шаг | Курс | Доступ |
|---|---|---|
| 1 | Основы Python | Бесплатно |
| 2 | Числовые основы: NumPy для машинного обучения | По подписке |
| 3 | Подготовка данных с pandas | По подписке |
| 4 | Основы машинного обучения | По подписке |
| 5 | PyTorch и глубокое обучение | По подписке |
Как это устроено:
- Код запускается прямо в браузере. NumPy, pandas, scikit-learn и PyTorch уже настроены во встроенном редакторе — ничего устанавливать не нужно.
- Автоматическая проверка. Каждое практическое задание проверяется сразу, каждый раздел завершается тестом.
- AI-помощник по обучению в каждом курсе знает материалы именно этого курса.
- Одна подписка — все курсы. Кроме ML-пути, открыты и смежные курсы: Linux, Docker, Claude Code и другие.
Попробовать формат можно с пробного периода: 7 дней доступа ко всем курсам по подписке. Актуальные условия и тарифы — на странице курсов по подписке.
Частые вопросы
С чего начать изучение машинного обучения с нуля?
С Python, а не с нейронных сетей. Порядок такой: базовый синтаксис Python → NumPy → pandas → классическое машинное обучение на scikit-learn → глубокое обучение на PyTorch. Каждый следующий шаг опирается на предыдущий: модель получает на вход массив NumPy, а этот массив почти всегда готовится в pandas.
Сколько времени нужно, чтобы изучить машинное обучение?
При 8–10 часах в неделю — примерно 8–12 месяцев до уровня, на котором вы самостоятельно доводите ML-проект от сырого файла до оценённой модели. Ориентировочно: Python — 4–6 недель, NumPy — 3–4 недели, pandas — 5–7 недель, классическое машинное обучение — 6–8 недель, PyTorch — 8–12 недель, плюс время на собственные проекты.
Какая математика нужна для машинного обучения?
Для старта достаточно школьной: функции, графики, среднее, проценты. Дальше добавляются линейная алгебра (векторы, матрицы), основы статистики (распределение, дисперсия, корреляция) и понятие производной и градиента. Их удобнее учить параллельно с кодом, а не отдельным курсом заранее.
Можно ли сразу начать с PyTorch и нейронных сетей?
Технически можно, но это самая частая причина, по которой новички бросают. Без NumPy непонятно, что такое форма тензора и broadcasting; без pandas нечем подготовить данные; без классического ML непонятно, что такое переобучение. PyTorch стоит брать четвёртым или пятым шагом.
NumPy или pandas — что учить первым?
NumPy. pandas построен поверх него, а модели scikit-learn и PyTorch получают на вход именно числовые массивы. Если ваша цель — аналитика, а не модели, можно начать с pandas и вернуться к NumPy позже.
PyTorch или TensorFlow — что выбрать в 2026 году?
Для обучения — PyTorch: код выглядит как обычный Python, ошибки читаются легче, а большинство современных открытых моделей публикуется именно на нём. Принципы одинаковы, поэтому перейти на другой фреймворк позже несложно.
Нужно ли учить машинное обучение, если есть ChatGPT и Claude?
Да, если вы хотите строить или оценивать модели, а не только пользоваться готовыми. AI-ассистент напишет код обучения, но не заметит утечки данных, неправильной метрики или переобучения. Это проверяет человек, который понимает, как модель учится.
Нужна ли мощная видеокарта для обучения?
Нет. Python, NumPy, pandas и scikit-learn работают на любом ноутбуке, а учебные сети в PyTorch обучаются на процессоре за минуты. GPU нужен для больших моделей — и тогда его берут в облаке.
Итог: что делать дальше
Машинное обучение с нуля — это не прыжок в нейронные сети, а пять последовательных ступеней: Python, NumPy, pandas, scikit-learn, PyTorch. На каждой вы получаете отдельный полезный навык, а не только «подготовку к следующей».
Три шага на ближайшую неделю:
- Оцените свой Python. Если функции, списки и словари ещё не автоматизм — начните с бесплатного курса Python.
- Возьмите NumPy. Первый раздел курса NumPy для машинного обучения покажет, комфортно ли вам с массивами.
- Запланируйте регулярность. 8–10 часов в неделю в течение года дают больше, чем 40 часов за одну неделю отпуска.
Весь маршрут — от первого массива до собственной языковой модели — доступен в одной подписке: посмотреть курсы по подписке Prog Academy.
Не знаешь, какую IT профессию выбрать?
Пройди короткий тест и получи персональную рекомендацию по курсу.
Пройти тест бесплатно