Машинне навчання з нуля: roadmap від NumPy і pandas до PyTorch
Машинне навчання (machine learning, ML) — це спосіб створювати програми, які знаходять правила самі, з прикладів, замість того щоб програміст прописував ці правила вручну. Ви даєте алгоритму дані з відомими відповідями, він підбирає закономірність — і потім застосовує її до нових даних, яких ще не бачив.
Вивчити машинне навчання з нуля реально, але більшість новачків спотикається не об складність, а об порядок: відкривають курс про нейронні мережі, не розуміють, що таке «форма тензора», і кидають. Ця стаття — roadmap із п'яти етапів: що вчити, у якій послідовності, скільки це займає і чим має закінчитися кожен крок.
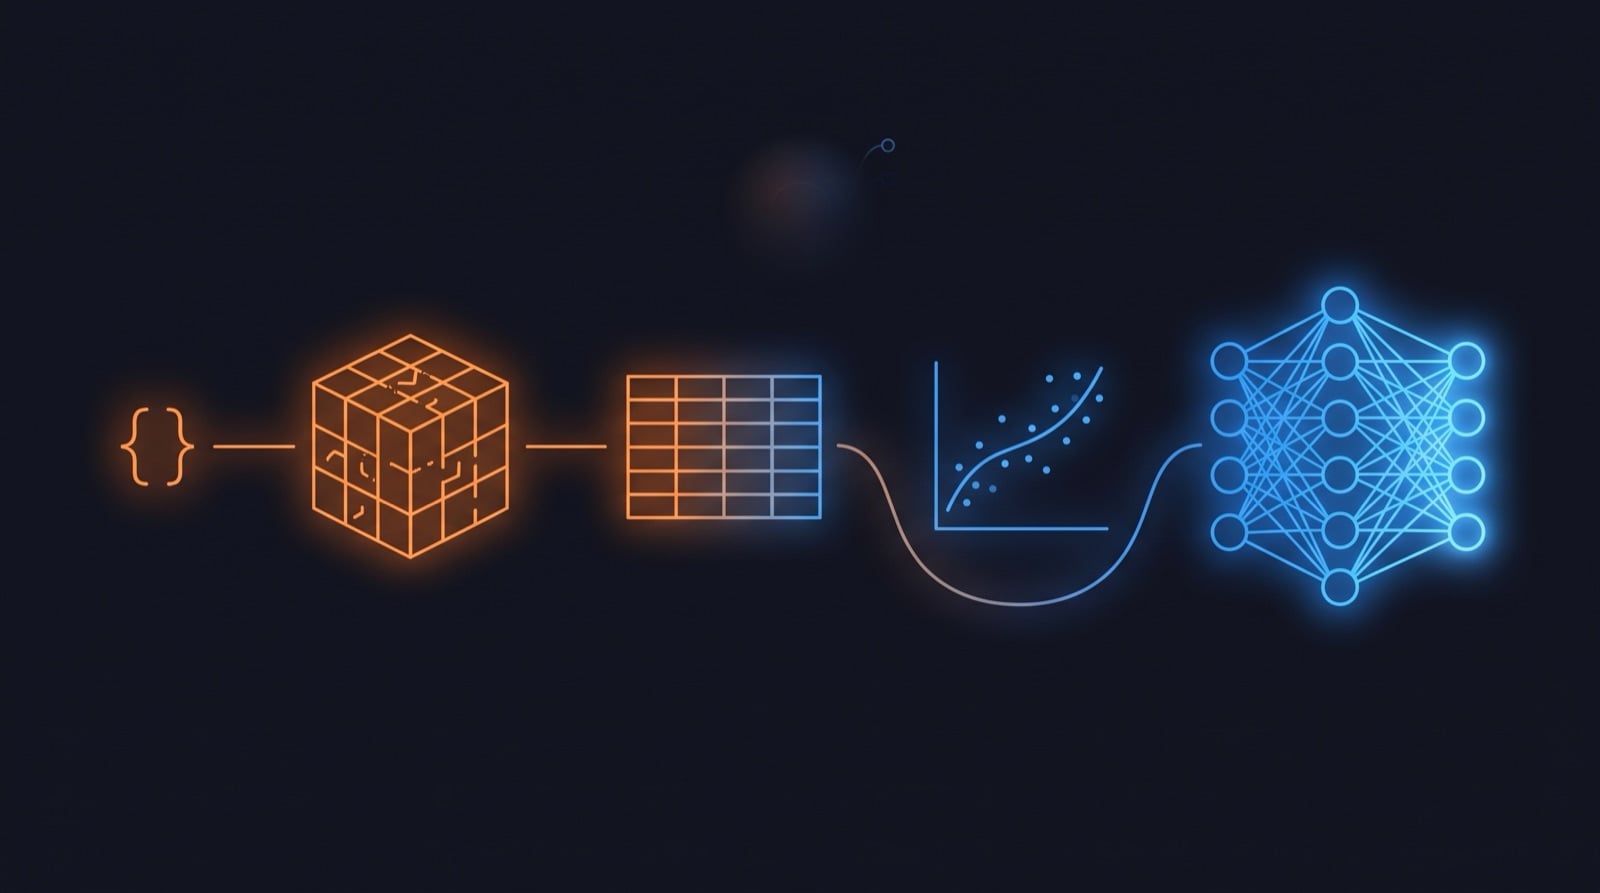
Коротко. Маршрут у машинне навчання: Python → NumPy → pandas → scikit-learn → PyTorch. NumPy дає мову масивів, якою «розмовляють» усі моделі; pandas перетворює брудні таблиці на дані для моделі; scikit-learn вчить класичних алгоритмів і чесної оцінки якості; PyTorch — нейронних мереж аж до трансформера. За 8–10 годин на тиждень увесь шлях займає 8–12 місяців. Математика потрібна, але шкільної достатньо для старту — решту добирають по дорозі.
Roadmap одним поглядом: 5 етапів
| Етап | Що вчите | Навіщо | Орієнтовний час* | Результат етапу |
|---|---|---|---|---|
| 1. Python | Змінні, цикли, функції, списки, словники | Мова, якою написано всю ML-екосистему | 4–6 тижнів | Пишете невеликі програми без підказок |
| 2. NumPy | Масиви, форма, зрізи, векторизація, broadcasting | Формат даних, який приймає будь-яка модель | 3–4 тижні | Лінійна регресія, написана вручну на NumPy |
| 3. pandas | DataFrame, пропуски, типи, дати, об'єднання, кодування ознак | Реальні дані брудні — їх треба готувати | 5–7 тижнів | Брудний файл перетворено на таблицю для моделі |
| 4. Класичне ML (scikit-learn) | Регресія, класифікація, метрики, перенавчання, кластеризація | Основа мислення: як модель вчиться і як її чесно оцінити | 6–8 тижнів | Повний ML-проєкт від даних до оціненої моделі |
| 5. Глибоке навчання (PyTorch) | Тензори, autograd, цикл навчання, CNN, RNN, увага, трансформер | Зображення, текст, мовні моделі | 8–12 тижнів | Власна маленька мовна модель |
* За 8–10 годин занять на тиждень. Це орієнтири для планування, а не норматив: з досвідом програмування перші етапи проходять удвічі швидше.
Саме в такій послідовності побудований навчальний шлях «Data Science і машинне навчання на Python» у курсах за підпискою Prog Academy: безкоштовний курс Python, далі NumPy, pandas, основи машинного навчання і PyTorch. Нижче — кожен етап докладно.
Чому порядок важливіший за швидкість
Кожен шар ML-стека стоїть на попередньому — буквально, на рівні коду:
- pandas побудований поверх NumPy. Стовпець DataFrame — це масив із підписами.
- scikit-learn приймає масиви. Метод
fit(X, y)очікує матрицю ознак певної форми — якщо ви не розумієте, що таке(n_samples, n_features), перша ж помилка поставить у глухий кут. - Тензор PyTorch — це масив NumPy з двома доповненнями: він уміє рахувати градієнти й працювати на GPU. Індексація, зрізи, broadcasting — ті самі.
Тому «перескочити» до нейронних мереж не виходить: прогалина з нижнього рівня повертається у вигляді незрозумілих помилок на верхньому. І навпаки — хто добре засвоїв NumPy, той читає код PyTorch майже без перекладу.
Етап 1. Python: рівно стільки, скільки потрібно
Для машинного навчання не потрібен «весь Python». Потрібен упевнений базовий рівень:
- змінні, типи, умови й цикли;
- функції та їхні аргументи;
- списки, словники, кортежі, зрізи;
- читання файлів і робота з модулями (
import); - основи класів — щоб розуміти запис на кшталт
class Net(nn.Module)у PyTorch.
Декоратори, метакласи, асинхронність на цьому етапі можна сміливо пропустити. Критерій готовності простий: ви можете без підказок написати функцію, яка читає файл, рахує по ньому статистику й повертає результат.
Де вчити: безкоштовний курс Python — перший крок навчального шляху, з практикою в браузері. Якщо вам ближча аналітика, ніж моделі, подивіться також гід «Python для аналізу даних».
Етап 2. NumPy: мова, якою розмовляють моделі
NumPy — це бібліотека Python для швидких обчислень над масивами чисел. Будь-яка модель машинного навчання — від лінійної регресії до нейронної мережі — отримує на вхід масиви чисел і повертає масиви чисел. Зображення — це масив пікселів, текст — масив номерів токенів, таблиця клієнтів — матриця «рядки × ознаки».
Що обов'язково зрозуміти:
- Форма масиву (shape) та осі. Більшість помилок новачків у ML — це помилки форми: модель чекає
(100, 3), а отримує(100,). - Індексація, зрізи й булеві маски — як дістати потрібні рядки й стовпці.
- Векторизація. Одна операція над усім масивом замість циклу — у десятки разів швидше й коротше.
- Агрегації по осях: середнє по стовпцях проти середнього по рядках.
- Broadcasting — правила, за якими NumPy поєднує масиви різної форми.
- Основи лінійної алгебри: скалярний добуток і множення матриць.
Ось як виглядає векторизація — стандартизація ознак без жодного циклу:
import numpy as np

X = np.array([[170, 65], [182, 80], [158, 52]])  # зріст, вага

# середнє і стандартне відхилення по кожному стовпцю (вісь 0)
X_scaled = (X - X.mean(axis=0)) / X.std(axis=0)
print(X_scaled.shape)  # (3, 2)
Тут в одному рядку працюють одразу три ідеї: агрегація по осі, broadcasting і векторизована арифметика. Саме так написано попередню обробку даних у реальних ML-проєктах.
Чим має закінчитися етап: ви реалізуєте лінійну регресію вручну — лише на NumPy, без готових бібліотек. Після цього «навчання моделі» перестає бути чорною скринькою.
Де вчити: курс «Числові основи: NumPy для машинного навчання» — 9 розділів від масивів і зрізів до broadcasting, а підсумковий проєкт — та сама лінійна регресія на NumPy.
Етап 3. pandas: від брудного файлу до даних для моделі
pandas — це бібліотека для роботи з таблицями (DataFrame): завантаження, очищення, перетворення й об'єднання даних. У навчальних датасетах дані чисті. У реальних — зайві пробіли в назвах, ціни на кшталт "$1,299.00", дати в трьох форматах, дублікати клієнтів і пропуски в половині стовпців.
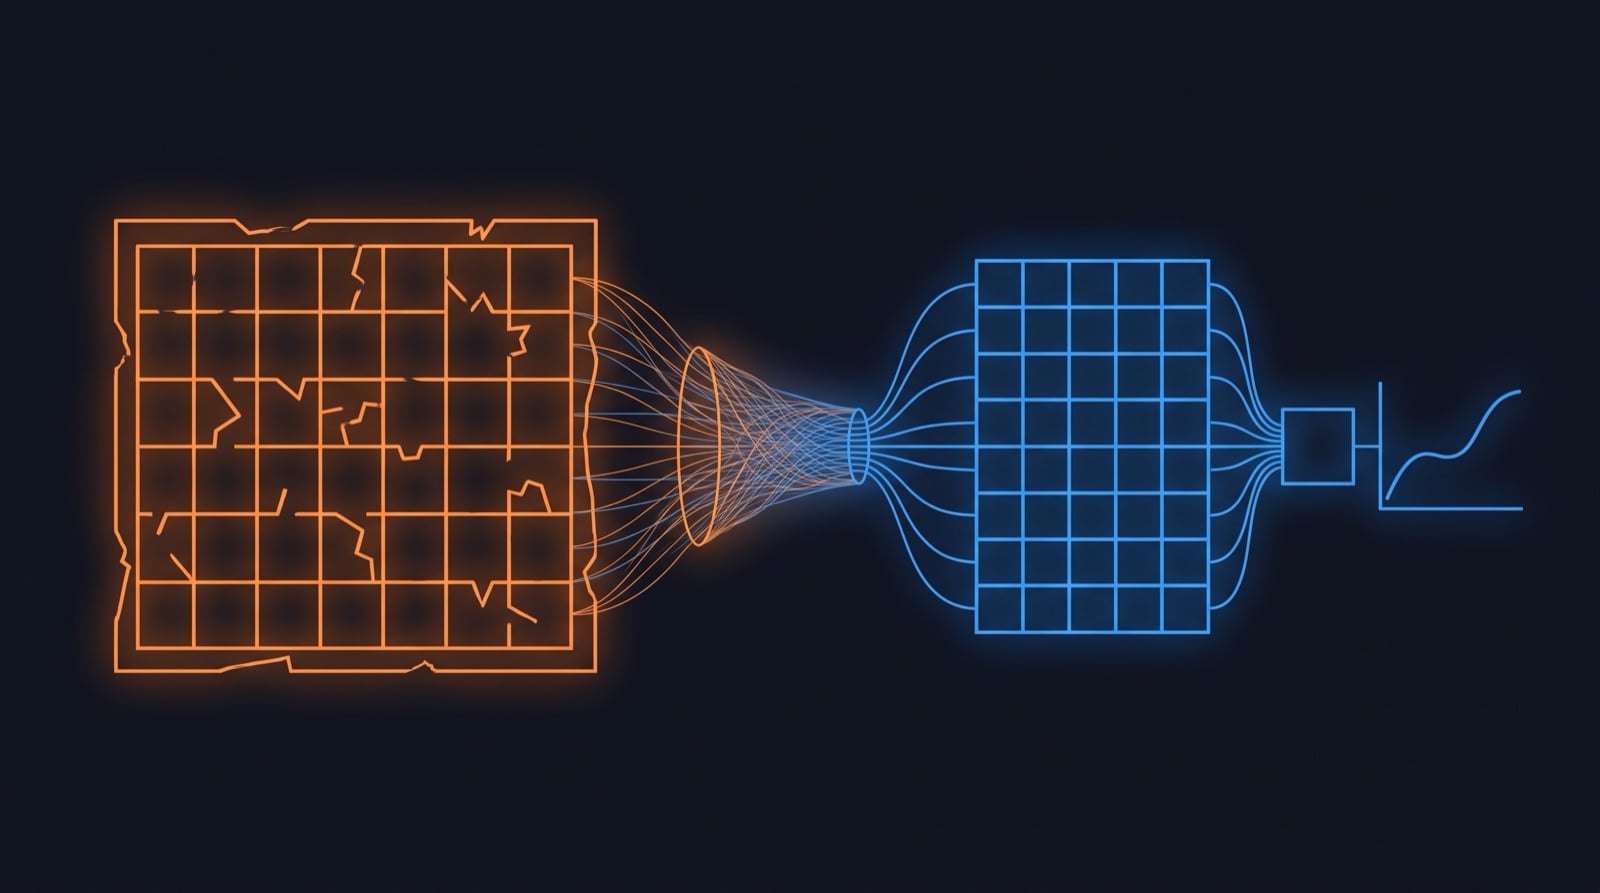
Якість моделі майже завжди обмежена якістю даних, а не вибором алгоритму. Тому підготовка даних — не «нудна частина перед справжнім ML», а більша половина роботи.
Що потрібно вміти:
- завантажувати CSV та Excel, швидко оглядати набір даних (
info,describe); - фільтрувати рядки й вибирати стовпці;
- працювати з пропущеними значеннями: знаходити, видаляти, заповнювати;
- виправляти типи, чистити текст, прибирати дублікати;
- розбирати дати й час;
- групувати й агрегувати (
groupby), об'єднувати таблиці (merge); - кодувати категоріальні ознаки й масштабувати числові;
- створювати нові ознаки (feature engineering) і знаходити викиди.
import pandas as pd

df = pd.read_csv("orders.csv")

df["price"] = df["price"].str.replace("[$,]", "", regex=True).astype(float)
df["city"] = df["city"].str.strip().str.title()
df = df.drop_duplicates(subset="order_id")
df["price"] = df["price"].fillna(df["price"].median())
Чотири рядки — і ціна стала числом, міста записані однаково, дублікати прибрані, пропуски заповнені. Такі правила пишуться один раз і застосовуються до кожного нового вивантаження.
Чим має закінчитися етап: ви берете справді брудний файл і проходите весь шлях до таблиці, на якій можна навчати модель.
Де вчити: курс «Підготовка даних з pandas: від брудного файлу до даних для моделі» — 13 розділів, включно з кодуванням, масштабуванням, інженерією ознак і підсумковим проєктом. Якщо дані у вас лежать у базі, знадобиться ще й SQL — див. «SQL для початківців».
Етап 4. Класичне машинне навчання на scikit-learn
Це серце всього маршруту. scikit-learn — стандартна бібліотека Python для класичного машинного навчання: в ній усі основні алгоритми мають однаковий інтерфейс fit / predict. Але головне на цьому етапі — не алгоритми, а спосіб мислення.
Три типи задач, які треба розрізняти
| Тип задачі | Що передбачаємо | Приклад | Типові метрики |
|---|---|---|---|
| Регресія | Число | Ціна квартири, попит на наступний тиждень | MAE, RMSE, R² |
| Класифікація | Категорію | Спам чи не спам, чи піде клієнт | Accuracy, precision, recall, F1 |
| Кластеризація (без учителя) | Групи, яких наперед ніхто не розмітив | Сегменти клієнтів | Silhouette, візуальна перевірка |
Ідеї, без яких далі не можна
- Ознаки й мітки. Що модель бачить на вході й що вона має передбачити.
- Чесний поділ на навчальну й тестову вибірки. Модель оцінюють лише на даних, яких вона не бачила.
- Перенавчання (overfitting) і недонавчання. Модель, що зазубрила навчальні приклади, показує чудову метрику на них і провалюється на нових.
- Крос-валідація — надійніша оцінка, ніж один поділ.
- Витік даних (data leakage). Якщо інформація з тестової вибірки потрапила в навчання, метрика бреше.
- Вибір метрики під задачу. Accuracy 99% нічого не означає, якщо 99% прикладів належать до одного класу.
Мінімальний повний цикл у scikit-learn виглядає так:
from sklearn.model_selection import train_test_split
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import f1_score

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

model = make_pipeline(StandardScaler(), LogisticRegression())
model.fit(X_train, y_train)

print(f1_score(y_test, model.predict(X_test)))
Зверніть увагу на make_pipeline: масштабування навчається лише на навчальній вибірці — це й є захист від витоку даних. Такі деталі відрізняють модель, що працює в ноутбуці, від моделі, що працює на реальних даних.
Чим має закінчитися етап: самостійний проєкт на табличних даних — від постановки задачі до висновку «модель дає таку-то якість, і ось чому їй можна (або не можна) довіряти».
Де вчити: курс «Основи машинного навчання: від першої моделі до готового ML-проєкту» — 10 розділів: дані й чесний поділ, регресія, класифікація та метрики, підготовка ознак у scikit-learn, перенавчання, кластеризація і підсумковий проєкт.
Етап 5. Глибоке навчання на PyTorch
Глибоке навчання (deep learning) — це частина машинного навчання, де модель складається з багатьох шарів нейронної мережі й сама вчиться виділяти ознаки із сирих даних: пікселів, звуку, тексту. PyTorch — фреймворк для побудови й навчання таких мереж; на ньому публікується більшість сучасних відкритих моделей.
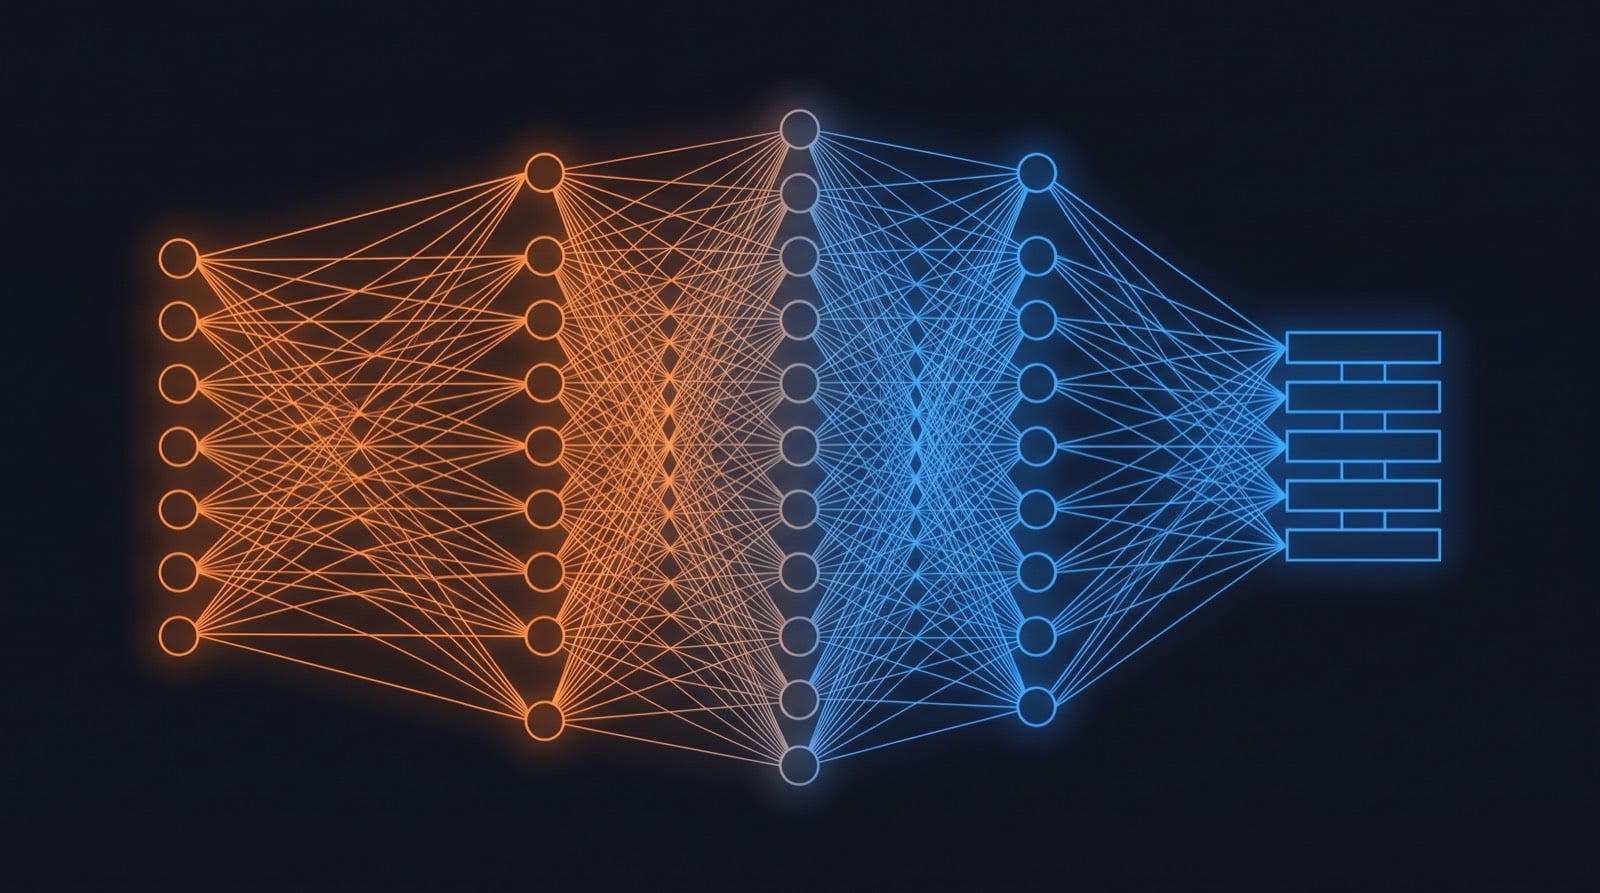
Послідовність тем усередині етапу теж має значення:
- Тензори — ті самі масиви NumPy, тільки з підтримкою GPU.
- Autograd — автоматичне обчислення градієнтів, двигун навчання будь-якої мережі.
- Модель як
nn.Module— шари, параметри, прямий прохід. - Цикл навчання: функція втрат, оптимізатор, епохи.
- Дані:
DatasetіDataLoader, батчі. - Згорткові мережі (CNN) — для зображень.
- Рекурентні мережі (RNN, LSTM, GRU) — для послідовностей.
- Регуляризація й робота з реальними даними.
- Механізм уваги (attention).
- Трансформер — архітектура, на якій побудовані GPT, Claude та інші великі мовні моделі.
Цикл навчання — п'ять рядків, які варто знати напам'ять, бо вони однакові і для мережі з двох шарів, і для мовної моделі:
for X_batch, y_batch in loader:
    optimizer.zero_grad()            # скидаємо старі градієнти
    loss = loss_fn(model(X_batch), y_batch)  # прямий прохід і втрати
    loss.backward()                  # градієнти через autograd
    optimizer.step()                 # оновлюємо ваги
Чим має закінчитися етап: ви збираєте трансформер і навчаєте власну маленьку мовну модель. Вона не замінить ChatGPT, але після цього ви розумієте, як влаштовані великі моделі — на рівні коду, а не метафор.
Де вчити: курс «PyTorch і глибоке навчання: від тензорів до трансформера» — просунутий курс із 10 розділів для тих, хто вже впевнено пише на Python: від тензорів і autograd до уваги, трансформера й власної мовної моделі.
Яка математика потрібна для машинного навчання
Найпоширеніший міф — «спочатку треба пів року вчити вищу математику». Насправді для старту вистачає шкільної, а решту зручніше добирати разом із кодом, коли видно, навіщо вона.
| Тема | Що саме потрібно | Де з'являється в маршруті |
|---|---|---|
| Лінійна алгебра | Вектори, матриці, скалярний добуток, множення матриць | NumPy (етап 2), шари нейронної мережі (етап 5) |
| Статистика | Середнє, медіана, дисперсія, розподіл, кореляція | pandas (етап 3), оцінка моделей (етап 4) |
| Аналіз | Похідна як «нахил», градієнт, ідея градієнтного спуску | Лінійна регресія на NumPy (етап 2), autograd (етап 5) |
| Ймовірність | Базові поняття: ймовірність події, умовна ймовірність | Класифікація й метрики (етап 4) |
Доводити теореми не потрібно. Потрібно розуміти, що робить операція з даними — і вміти перевірити це кодом на маленькому прикладі.
Скільки часу займає весь шлях
Якщо скласти етапи, виходить 26–37 тижнів чистого навчання, тобто 6–9 місяців за 8–10 годин на тиждень. Додайте час на власні проєкти й повторення — і реалістична оцінка становить 8–12 місяців до рівня, на якому ви самостійно ведете ML-проєкт від сирих даних до оціненої моделі.
- Через 2–3 місяці (Python + NumPy) ви вільно працюєте з масивами й розумієте, як влаштоване навчання найпростішої моделі.
- Через 4–5 місяців (+ pandas) ви готуєте реальні дані — цього вже достатньо для задач аналітики.
- Через 6–7 місяців (+ класичне ML) у вас є перший повний ML-проєкт для портфоліо.
- Через 9–12 місяців (+ PyTorch) ви будуєте й налагоджуєте нейронні мережі.
Маршрут не обов'язково проходити до кінця. Для аналітика даних природна точка зупинки — після етапу 4: про цю роль докладніше в статтях «Професія аналітик даних» та «AI + Data Analytics».
Проєкти для портфоліо на кожному етапі
| Етап | Проєкт | Що він доводить |
|---|---|---|
| NumPy | Лінійна регресія з градієнтним спуском без бібліотек ML | Ви розумієте, що відбувається всередині fit |
| pandas | Очищення та дослідження відкритого «брудного» датасету | Ви вмієте працювати з реальними даними |
| scikit-learn | Передбачення відтоку клієнтів або ціни з порівнянням кількох моделей | Ви вмієте чесно оцінювати якість і пояснювати вибір метрики |
| PyTorch | Класифікатор зображень на CNN або маленька мовна модель | Ви вмієте будувати й налагоджувати нейронні мережі |
Один доведений до кінця проєкт з описом у README цінніший за десять незакінчених ноутбуків. Викладайте код на GitHub — якщо ще не працювали з ним, почніть із гіда «Git для початківців».
7 помилок, через які новачки кидають машинне навчання
- Почати з нейронних мереж. Без NumPy і класичного ML це заучування чужого коду.
- Пів року вчити математику «про запас». Мотивація закінчується раніше, ніж з'являється перша модель.
- Дивитися відео замість писати код. Розуміння з'являється, тільки коли ви самі виправляєте помилку форми масиву.
- Працювати лише з чистими навчальними датасетами. Перший реальний файл стає шоком.
- Оцінювати модель на даних, на яких вона вчилася. Метрика виходить чудовою і нічого не означає.
- Просити AI написати все за вас. Асистент корисний як викладач — «поясни цей рядок», — але не як заміна розумінню.
- Не доводити проєкти до кінця. Саме останні 20% — оцінка, висновки, оформлення — і показують рівень.
Машинне навчання в епоху ChatGPT і Claude: чи є сенс вчити
Великі мовні моделі змінили те, як пишуть код, але не скасували потребу розуміти моделі. Навпаки:
- AI пише код навчання за секунди — і так само впевнено помиляється. Витік даних, неправильна метрика, перенавчання не видно в коді, що «просто працює». Їх бачить лише той, хто розуміє процес.
- Більшість бізнес-задач — табличні. Прогноз попиту, скоринг, відтік клієнтів розв'язують класичним ML, а не мовними моделями: це дешевше, швидше й легше пояснити.
- LLM — це теж нейронні мережі. Розуміння трансформера допомагає тверезо оцінювати, що модель може, а чого ні, — і будувати на ній продукти. Практичний бік цього описано в статті «Як створити AI-агента на Python».
Попит це підтверджує: Бюро статистики праці США прогнозує зростання зайнятості data scientists на 34% у 2024–2034 роках — значно швидше за середній темп по ринку.
Як пройти цей roadmap у Prog Academy
Усі п'ять етапів зібрані в навчальний шлях «Data Science і машинне навчання на Python». Досвід програмування не потрібен — перший курс починається з нуля; знадобиться шкільна математика.
| Крок | Курс | Доступ |
|---|---|---|
| 1 | Основи Python | Безкоштовно |
| 2 | Числові основи: NumPy для машинного навчання | За підпискою |
| 3 | Підготовка даних з pandas | За підпискою |
| 4 | Основи машинного навчання | За підпискою |
| 5 | PyTorch і глибоке навчання | За підпискою |
Як це влаштовано:
- Код запускається прямо в браузері. NumPy, pandas, scikit-learn і PyTorch уже налаштовані у вбудованому редакторі — нічого встановлювати не потрібно.
- Автоматична перевірка. Кожне практичне завдання перевіряється одразу, кожен розділ завершується тестом.
- AI-помічник з навчання у кожному курсі знає матеріали саме цього курсу.
- Одна підписка — усі курси. Крім ML-шляху, відкриті й суміжні курси: Linux, Docker, Claude Code та інші.
Спробувати формат можна з пробного періоду: 7 днів доступу до всіх курсів за підпискою. Актуальні умови й тарифи — на сторінці курсів за підпискою.
Часті запитання
З чого почати вивчення машинного навчання з нуля?
З Python, а не з нейронних мереж. Порядок такий: базовий синтаксис Python → NumPy → pandas → класичне машинне навчання на scikit-learn → глибоке навчання на PyTorch. Кожен наступний крок спирається на попередній: модель отримує на вхід масив NumPy, а цей масив майже завжди готується в pandas.
Скільки часу потрібно, щоб вивчити машинне навчання?
За 8–10 годин на тиждень — приблизно 8–12 місяців до рівня, на якому ви самостійно доводите ML-проєкт від сирого файлу до оціненої моделі. Орієнтовно: Python — 4–6 тижнів, NumPy — 3–4 тижні, pandas — 5–7 тижнів, класичне машинне навчання — 6–8 тижнів, PyTorch — 8–12 тижнів, плюс час на власні проєкти.
Яка математика потрібна для машинного навчання?
Для старту достатньо шкільної: функції, графіки, середнє, відсотки. Далі додаються лінійна алгебра (вектори, матриці), основи статистики (розподіл, дисперсія, кореляція) і поняття похідної та градієнта. Їх зручніше вчити паралельно з кодом, а не окремим курсом наперед.
Чи можна одразу почати з PyTorch і нейронних мереж?
Технічно можна, але це найчастіша причина, чому новачки кидають. Без NumPy незрозуміло, що таке форма тензора й broadcasting; без pandas нема чим підготувати дані; без класичного ML незрозуміло, що таке перенавчання. PyTorch варто брати четвертим або п'ятим кроком.
NumPy чи pandas — що вчити першим?
NumPy. pandas побудований поверх нього, а моделі scikit-learn і PyTorch отримують на вхід саме числові масиви. Якщо ваша мета — аналітика, а не моделі, можна почати з pandas і повернутися до NumPy пізніше.
PyTorch чи TensorFlow — що обрати у 2026 році?
Для навчання — PyTorch: код виглядає як звичайний Python, помилки читаються легше, а більшість сучасних відкритих моделей публікується саме на ньому. Принципи однакові, тож перейти на інший фреймворк згодом нескладно.
Чи потрібно вчити машинне навчання, якщо є ChatGPT і Claude?
Так, якщо ви хочете будувати або оцінювати моделі, а не лише користуватися готовими. AI-асистент напише код навчання, але не помітить витоку даних, неправильної метрики чи перенавчання. Це перевіряє людина, яка розуміє, як модель вчиться.
Чи потрібна потужна відеокарта для навчання?
Ні. Python, NumPy, pandas і scikit-learn працюють на будь-якому ноутбуці, а навчальні мережі в PyTorch навчаються на процесорі за хвилини. GPU потрібен для великих моделей — і тоді його беруть у хмарі.
Підсумок: що робити далі
Машинне навчання з нуля — це не стрибок у нейронні мережі, а п'ять послідовних сходинок: Python, NumPy, pandas, scikit-learn, PyTorch. На кожній ви отримуєте окрему корисну навичку, а не лише «підготовку до наступної».
Три кроки на найближчий тиждень:
- Оцініть свій Python. Якщо функції, списки й словники ще не автоматизм — почніть із безкоштовного курсу Python.
- Візьміть NumPy. Перший розділ курсу NumPy для машинного навчання покаже, чи комфортно вам із масивами.
- Заплануйте регулярність. 8–10 годин на тиждень протягом року дають більше, ніж 40 годин за один тиждень відпустки.
Увесь маршрут — від першого масиву до власної мовної моделі — доступний в одній підписці: переглянути курси за підпискою Prog Academy.
Не знаєш, яку IT-професію обрати?
Пройди короткий тест і отримай персональну рекомендацію щодо курсу.
Пройти тест безкоштовно