Почему код от нейросети падает на реальных пользователях: 7 правил, которые нужно задать до первого промпта
«На днях Claude написал мне плохой код». Так начинается наше короткое видео об AI-автоматизации, и эта фраза знакома многим, кто создаёт проекты с нейросетями без технического образования. Код запускается, на компьютере автора всё работает, но к реальным людям проект не готов.
Причина почти всегда одна: нейросеть не получила правил. В этой статье разберём, что именно модель решает за вас, когда вы молчите, и какие 7 правил стоит задать ещё до первого промпта, чтобы код от Claude, ChatGPT или Codex не ломался на первых пользователях. В конце — шаблон, который можно скопировать в свой проект.
Коротко: 7 правил до первого промпта
- Кто и сколько людей будет пользоваться проектом одновременно.
- На каком языке и каком фреймворке его писать.
- Где хранить данные: база данных, а не файл или память программы.
- Где он будет работать: ваш компьютер, сервер или облачный сервис.
- Что делать с ошибками: логи, повторные попытки, уведомления.
- Где лежат ключи доступа и кто какие данные видит.
- Как проверить, что результат готов.
Кейс: Claude написал код, который не переживёт 2–3 пользователей
История из видео короткая. «Скажу честно, я расслабился за последний год»: Claude, Codex и похожие инструменты сильно выросли в качестве, поэтому задача была поставлена одной фразой — «сделай мне необходимую автоматизацию для бизнеса».
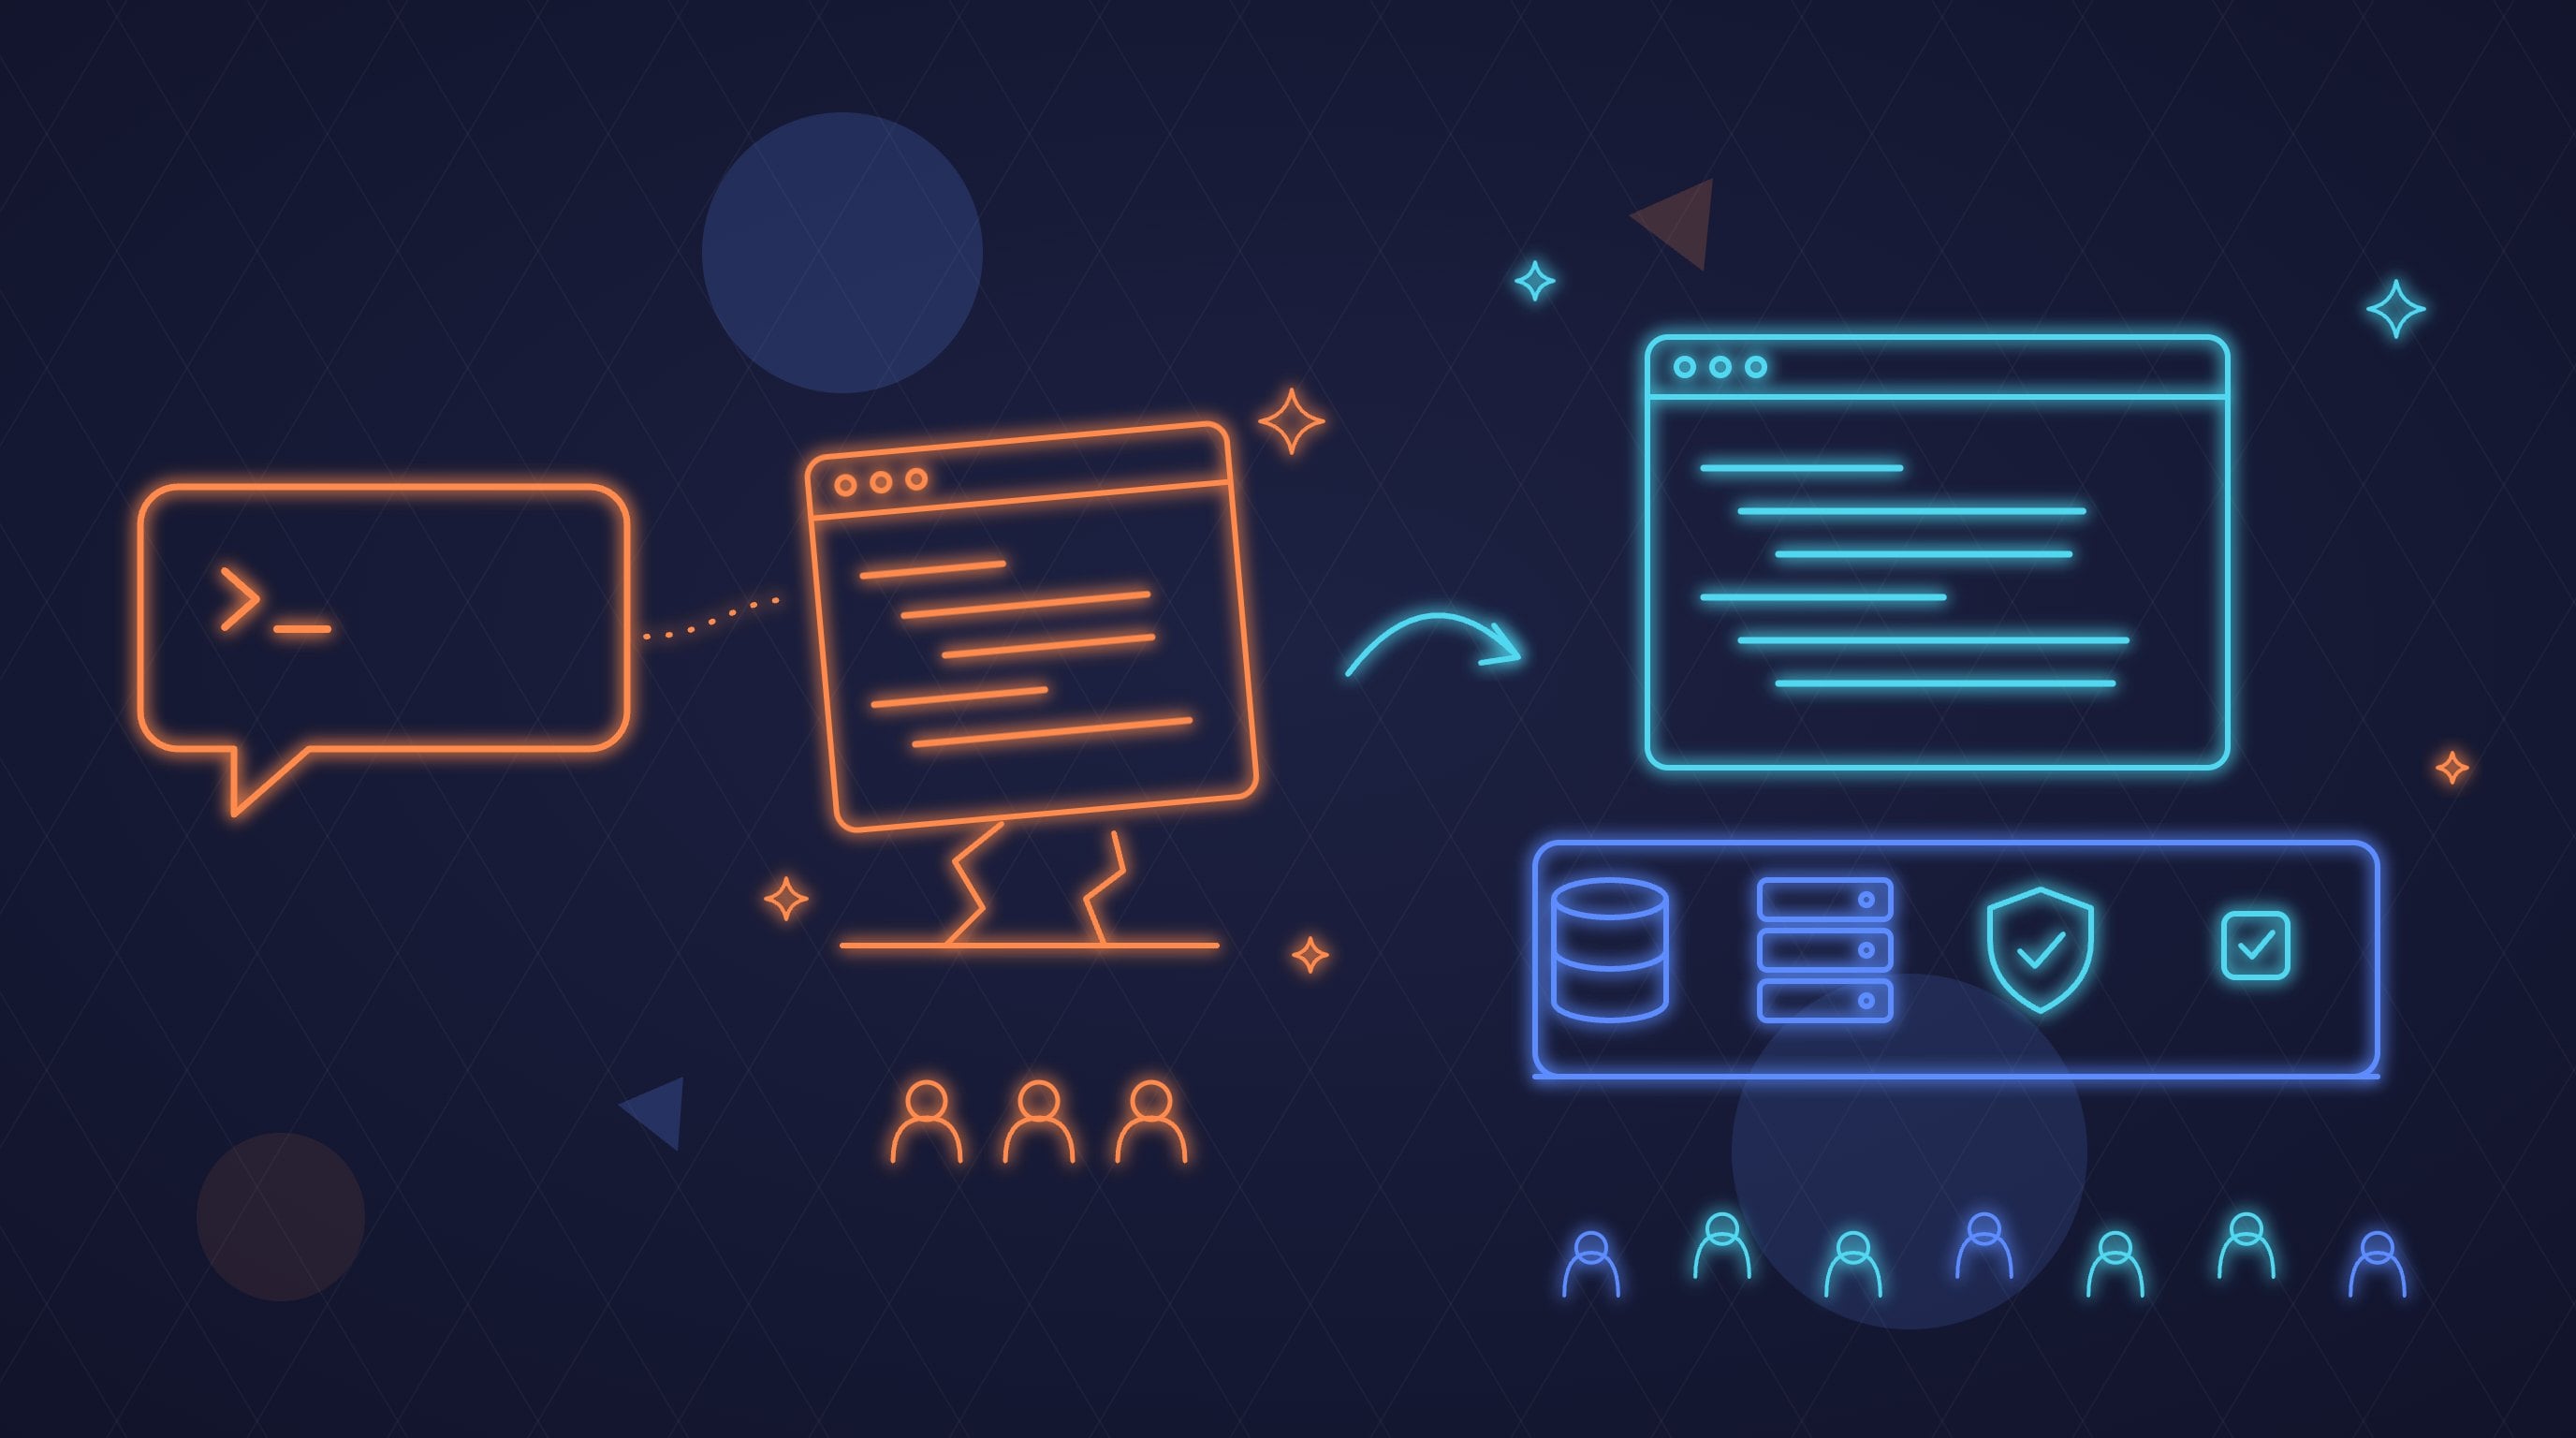
Результат разочаровал: проект, «который просто не переживёт больше 2–3 пользователей». Причина, по словам автора, в том, что нужно было заранее задать правила — технические детали, «такие как язык программирования, фреймворк, база данных, которую нужно использовать».
Цифра «2–3 пользователя» — наблюдение автора о конкретном проекте, а не общее правило. Но сам сценарий типичен: нейросеть выдаёт решение, рассчитанное на одного человека за одним компьютером, потому что именно такую задачу она и получила.
Почему нейросеть пишет «рабочий», но слабый код
Короткий ответ: модель заполняет каждый пробел в вашем запросе самым простым решением, которое выполняет задачу прямо сейчас. Если вы не сказали, сколько будет пользователей, где хранить данные и где будет работать программа, нейросеть выберет вариант «для демонстрации»: всё в одном файле, данные в памяти или в текстовом файле, запуск на вашем компьютере. Это не ошибка модели, а честное выполнение размытой задачи.
Иллюзия «у меня на компьютере работает»
Когда вы проверяете проект сами, вы — единственный пользователь. Вы делаете одно действие за раз, у вас стабильный интернет, правильные ключи доступа, и никто параллельно не меняет те же данные. В таких условиях работает почти любой код.
Реальные пользователи приходят одновременно, отправляют неожиданные данные, закрывают вкладку посреди действия. Внешние сервисы — API модели, CRM — время от времени не отвечают. Именно здесь проявляются решения, которые никто не принимал осознанно. Как довести такой проект до реальных людей, мы отдельно разобрали в чек-листе «У меня на компьютере работает»: от прототипа до продакшена.
Что нейросеть решает за вас, когда вы молчите
| Вопрос, который вы не задали | Что нейросеть часто выбирает по умолчанию | Что произойдёт с реальными людьми |
|---|---|---|
| Сколько людей будет работать одновременно? | Код, рассчитанный на одного пользователя | Действия разных людей мешают друг другу |
| Где хранить данные? | Переменная в памяти программы, JSON-файл или память браузера | Данные пропадают после перезапуска или перезаписывают друг друга |
| Где это будет работать? | Запуск на вашем компьютере | Ноутбук уснул — бот перестал отвечать |
| Что делать, если внешний сервис не ответил? | Ничего: программа просто останавливается с ошибкой | Заявки теряются, и никто об этом не знает |
| Где хранить ключи доступа? | Прямо в коде | Ключ попадает в Git или к посторонним |
Ни один из этих вариантов не «неправильный» для быстрой демонстрации. Они неправильные для проекта, которым будут пользоваться люди. А модель не может знать, что именно вы строите, если вы ей этого не сказали.
7 правил, которые нужно задать до первого промпта
Эти правила не требуют умения программировать. Каждое из них — решение, которое вы принимаете как владелец проекта, а нейросеть потом выполняет. Если не знаете, что выбрать, попросите модель предложить два-три варианта с плюсами и минусами, но окончательное решение зафиксируйте вы.
1. Кто и сколько людей будет пользоваться проектом
Начните с описания пользователей: кто они, сколько их будет одновременно и за день, с каких устройств они заходят. «Бот для записи клиентов салона: до 20 человек одновременно, несколько сотен сообщений в день, в основном с телефона» — это уже совсем другая задача, чем просто «бот для записи».
Одно это предложение заставляет модель думать об одновременных действиях, отдельных данных для каждого клиента и о том, что бот должен работать без вашего компьютера.
2. Язык программирования и фреймворк
Если не указать технологии, нейросеть выберет что-то на свой вкус, а в следующей сессии может выбрать другое. Попросите предложить распространённую, зрелую комбинацию с большим сообществом — например, Python с популярным фреймворком или JavaScript/TypeScript с Node.js, — и зафиксируйте выбор в правилах.
Фреймворк — это готовый каркас с проверенными решениями для типовых задач. Он защищает от того, чтобы нейросеть изобретала собственную обработку запросов, сессий или форм, которая работает только в самом простом случае. Добавьте правило: «не меняй язык и фреймворк и не добавляй новые библиотеки без моего согласия».
3. База данных, а не файл или память программы
Именно это правило чаще всего отделяет демонстрацию от рабочего проекта. Данные в переменной программы пропадают после перезапуска. Данные в JSON-файле могут испортиться, когда два человека сохраняют что-то одновременно. Данные в памяти браузера видит только тот, кто их создал.
База данных создана как раз для того, чтобы надёжно хранить данные и корректно обрабатывать одновременные изменения. Для небольшого проекта на одном сервере может хватить SQLite, для сервиса со множеством пользователей чаще выбирают PostgreSQL, а у no-code платформ есть собственные хранилища. Напишите прямо: «все данные храни в базе данных; никаких данных в памяти программы или в файлах».
4. Где это будет работать
Ваш компьютер — не сервер: он выключается, засыпает и меняет сеть. Заранее решите, где будет жить проект: на облачном сервере, на платформе вроде Lovable или в n8n / Make. От этого зависит, как хранить настройки, как перезапускать программу после сбоя и как обновлять её без потери данных.
Полезное правило: «проект должен работать на сервере 24/7; после перезапуска ничего не должно теряться; все настройки бери из переменных окружения».
5. Ошибки, логи и повторные попытки
Любая автоматизация зависит от внешних сервисов: API модели, CRM, почты, Telegram. Рано или поздно один из них не ответит, ответит медленно или вернёт ошибку. Код «для демонстрации» в такой ситуации просто падает, и вы даже не узнаете, что заявка клиента потерялась.
Задайте правила заранее: «у каждого вызова внешнего сервиса есть ограничение времени ожидания и до трёх повторных попыток; каждая ошибка записывается в лог; о критичных ошибках присылай мне уведомление; сбой у одного человека не должен останавливать работу для всех».
6. Ключи доступа и права
Ключи к API, пароли к базе данных и токены ботов не должны жить в коде. Они хранятся отдельно — например, в файле .env или в настройках платформы, — и этот файл никогда не попадает в Git.
Вторая половина этого правила — кто что видит. Если в проекте несколько клиентов или сотрудников, каждый должен видеть только свои данные. Скажите об этом прямо, иначе нейросеть легко сделает один общий список для всех. Подробнее о безопасной работе с AI — в курсе «Кибербезопасность с ИИ».
7. Как проверить результат
Опишите, что считается «готово», ещё до начала работы. Не «бот работает», а проверяемые условия: «два человека одновременно записываются на одно и то же время — запись получает только один»; «после перезапуска сервера все записи на месте»; «если API не отвечает, клиент видит понятное сообщение, а я получаю уведомление».
Такие критерии нейросеть может превратить в автоматические тесты, а вы — проверить руками. Попросите агента после каждого изменения запускать тесты и показывать результат.
Шаблон: правила проекта на одну страницу
Скопируйте этот блок в начало первого промпта или сохраните как файл правил проекта. Claude Code автоматически читает файл CLAUDE.md в папке проекта, а Codex и другие агенты — AGENTS.md. Как это работает, мы объяснили в полном руководстве по Claude Code.
# Правила проекта

## Что строим
Telegram-бот для записи клиентов в салон красоты.
Пользователи: клиенты салона (до 20 одновременно, несколько сотен
сообщений в день) и 2 администратора.

## Технологии
- Язык и фреймворк: [ваш выбор, например Python + aiogram].
- Не меняй язык, фреймворк и не добавляй новые библиотеки
  без моего согласия.

## Данные
- Все данные храни в базе данных [например PostgreSQL].
- Никаких данных в переменных программы, JSON-файлах или памяти браузера.
- Два человека не могут записаться на одно и то же время.

## Где работает
- Проект работает на сервере 24/7, не на моём компьютере.
- После перезапуска ничего не теряется.
- Все настройки и ключи — из переменных окружения (.env), .env не в Git.

## Ошибки
- У каждого вызова внешнего сервиса: ограничение времени и до 3 повторных попыток.
- Каждая ошибка пишется в лог; о критичных — сообщение администратору.
- Ошибка у одного клиента не останавливает бота для остальных.

## Доступы
- Клиент видит только свои записи; полный список — только администраторы.

## Как работаем
- Сначала план, потом код. Перед большими изменениями спрашивай меня.
- После каждого изменения запускай тесты и показывай результат.
- Объясняй решения простыми словами: я не программист.

## Готово, когда
- Два клиента одновременно выбирают одно время — запись получает только один.
- После перезапуска сервера все записи на месте.
- Если API не отвечает, клиент видит понятное сообщение.
Оставьте скобки пустыми и попросите модель: «Предложи 2–3 варианта для каждого пустого пункта с плюсами и минусами для моего проекта. Код пока не пиши». Выберите вариант, впишите его в правила и только потом начинайте разработку.
Хотите научиться закладывать фундамент самостоятельно?
Курс AI Automation от Prog Academy рассчитан на людей без IT-бэкграунда. В программе есть модули «Что такое Vibecoding» (постановка задач, архитектурное мышление, ошибки и ограничения AI), «Lovable для продуктов» (базы данных, аутентификация, деплой) и «Продвинутый Vibecoding» с Claude Code и OpenAI Codex.
Посмотреть программу AI AutomationКак проверить код от нейросети, если вы не программист
Читать каждую строку не нужно. Достаточно задать агенту правильные вопросы и выполнить несколько простых проверок руками.
- Попросите объяснить архитектуру. «Объясни простыми словами, из каких частей состоит проект, где хранятся данные и что происходит, когда пользователь нажимает кнопку». Если в ответе появляются «список в памяти» или «файл data.json», правило №3 не выполнено.
- Спросите о нагрузке. «Что сломается, если 20 человек сделают это одновременно? Покажи самые слабые места». Модель хорошо находит слабые места, когда её прямо об этом спрашивают.
- Сделайте тест двух вкладок. Откройте проект в двух браузерах или с двух аккаунтов и выполните одно и то же действие одновременно. Проверьте, что данные не перемешались и не перезаписались.
- Перезапустите. Остановите и снова запустите программу или сервер. Все данные должны остаться на месте.
- Сломайте намеренно. Укажите неправильный ключ API или временно отключите интернет. Проект должен показать понятное сообщение и записать ошибку, а не «молча» потерять данные.
- Поищите ключи в коде. Попросите: «Проверь, нет ли в коде ключей, паролей или токенов, и добавлен ли файл .env в .gitignore».
- Попросите второй взгляд. Дайте код другой модели или новой сессии с задачей: «Ты опытный разработчик. Найди проблемы с надёжностью, безопасностью и одновременной работой нескольких пользователей».
Если проект работает с платежами, паролями или персональными данными, этих проверок недостаточно: перед запуском его должен посмотреть опытный разработчик.
Чему научиться, чтобы закладывать фундамент самостоятельно
Правила из этой статьи — минимум, который закрывает самые частые проблемы. Чтобы принимать такие решения уверенно, а не копировать шаблон, нужно понимать несколько базовых вещей. Речь не о программировании, а о том, как устроены проекты:
- как работает веб: запросы, сервер, API, HTTPS — этому посвящён курс «Как работает веб»;
- что такое фреймворк, база данных и деплой и чем они отличаются в разных инструментах;
- как ставить задачу AI-агенту и проверять результат — об этом наш первый проект по вайб-кодингу с Claude Code и курс Claude Code для начинающих;
- как собрать автоматизацию без кода, где часть этих решений берёт на себя платформа, — см. n8n для начинающих.
Именно этому учат на курсе AI Automation: людям с нуля, которые не программисты, дают базу, чтобы, беря новый проект в работу, они сразу закладывали правильный фундамент, а их проекты работали качественно, долго и не падали на продакшене. Чем занимается такой специалист, мы описали в гиде «AI Automation: полный гид по профессии».
Частые вопросы
Можно ли делать автоматизации с AI без программирования?
Да. Инструменты вроде Make, n8n, Lovable или Claude Code позволяют собрать рабочую автоматизацию без опыта программирования. Но технические решения всё равно придётся принимать: где хранятся данные, где это работает, что делать с ошибками. Если их не принять, их примет нейросеть — и чаще всего выберет самый простой вариант, который работает только для одного человека.
Почему Claude или ChatGPT пишут разный код на один и тот же запрос?
Потому что общий запрос вроде «сделай мне автоматизацию» оставляет модели много свободных решений: язык, библиотеки, способ хранить данные. Каждый раз модель может заполнить эти пробелы по-разному. Чем больше решений вы зафиксируете в правилах проекта, тем предсказуемее будет результат.
Что такое фреймворк и база данных простыми словами?
Фреймворк — это готовый каркас для программы с проверенными решениями для типовых задач: как принимать запросы, как строить страницы, как работать с данными. База данных — это отдельная программа для надёжного хранения данных, которая не теряет их после перезапуска и корректно обрабатывает одновременные изменения от нескольких людей.
Безопасно ли запускать код от нейросети для клиентов?
Только после проверки. Перед запуском убедитесь, что ключи доступа не лежат в коде, каждый пользователь видит только свои данные, ошибки не ломают всю систему, а данные хранятся в базе с резервными копиями. Проекты с платежами или персональными данными должен посмотреть опытный разработчик.
Сколько нужно знать, чтобы не «уронить» проект?
Становиться программистом не нужно. Достаточно понимать базовые понятия — фреймворк, база данных, сервер, API, ключи доступа, логи — и уметь задавать о них нейросети правильные вопросы. Именно эти основы позволяют заложить фундамент, на котором проект будет работать долго.
Вывод
Нейросети стали намного лучше писать код, но не научились читать мысли. Промпт «сделай мне автоматизацию» даёт модели свободу принять десятки решений, и она примет их так, чтобы демонстрация работала на вашем компьютере. Чтобы проект выдержал реальных людей, эти решения должны быть вашими: кто пользователи, какие технологии, где данные, где сервер, что с ошибками, где ключи и что считается «готово».
Начните следующий проект с шаблона выше. Заполнить его — дело нескольких минут, а переделывать фундамент уже работающего проекта гораздо дольше.
Стройте автоматизации, которые не падают на первых пользователях
AI Automation — практический онлайн-курс Prog Academy для людей без технического бэкграунда: ChatGPT, Claude, Make, n8n, AI-агенты, вайб-кодинг с Claude Code и OpenAI Codex и создание MVP.
Узнать больше о курсе AI Automation
Об авторе
Читайте также
- «У меня на компьютере работает»: как довести AI-автоматизацию от прототипа до продакшена — чек-лист для непрограммистов
- Вайб-кодинг с Claude Code: первый проект с нуля — пошаговая инструкция для начинающих
- Claude Code: полное руководство в 2026 году — что это, как работает и как использовать
- AI Automation: полное руководство по профессии AI Automation Engineer в 2026 году